레이블이 해외주식인 게시물을 표시합니다. 모든 게시물 표시

2024년 11월 17일 일요일

ASML DRAM Memory

최근 ASML의 Investor day에서 DRAM의 향 후 전망에 대해 좋은 자료들이 있어 글을 정리해본다, 

1.

2년마다 칩당 트랜지스터 집적도가 2배씩 올라간다는 무어의법칙은 더 이상 존재하지 않고 대신, 칩당이 아닌 패키지당 트랜지스터 집적도가 2년에 2배씩 올라가는 개념인 매슬로우법칙이 미래를 설명해줄 것이라고 한다.  
 

2. 

지난 무어의법칙의 세계에서는 2년마다 트랜지스터밀도가 2배씩 높아짐에 따라 에너지소모를 60%씩 낮춰줬지만, 반대로 매슬로우법칙에서는 2년마다 에너지소모가 5배씩 늘어날 예정이라고 한다. 

또한, 앞으로 AI시대에서는 2년마다 필요 에너지가 16x씩 증가할 것이라고한다. 이는 이전 무어의세계 대비 8x나 빠른 속도라고 하며, 동시에

칩당 에너지감소는 고사하고,  2년마다 패키지당 5x의 필요에너지증가가 이뤄날 것이라고 하니, ai시대 필요 에너지는 기하급수적으로 늘어날 예정이라고 하며, 이는 다시 비용문제, 전력소비문제와 직결될 것이라고 한다.


3. 

AI가 세상에 나오기 전까지만 하더라도 2nm 이하 고급로직 수요에 대한 의구심과 불확실성이 존재했었지만, AI가 세상에 나온 이후 고급로직 수요는 끊이질 않고 있다고 하며, 그 이유는 2nm 이하 고급로직만이 앞으로 AI시대 증가할 비용과 전력소비 문제를 해결줄 수 있기 때문이라고 한다. 


4.

로직 비메모리 반도체시장이 첨단화되면서 DRAM 메모리 시장 병목화는 더욱 심화될 예정이라고 한다. 그 이유는 현재 DRAM의 구조상 30~40%만이 실제 컴퓨팅에 사용되고 있기 때문이라고 하며, 이러한 병목을 줄이기 위해선 메모리에서 연산기능 일부를 지원해줘야 하는 PIM로 가야 전체 로직 반도체의 성능 향상, 속도개선, 전력 소비 감소가 이뤄질 것이라고 한다. HBM은 이러한 DRAM의 로드맵 변경의 첫번째 단계라고 한다.   


5. 

특히, ASML은 앞으로 AI 시대의 로직 반도체 내에서 메모리 시장. 그 중에서도 DRAM의 성장이 더욱 가속화 될 예정이라고 한다. 특히 ASML의 EUV를 사용하면, DRAM 700~750 공정 중 100공정 이상을 건너뛰어 HBM을 제작할 수 있다고하며, 이는 DRAM 고객사의 비용절감, 사이클 시간 단축으로 이어져 큰 이점이 될 것이라고 한다. 


6.

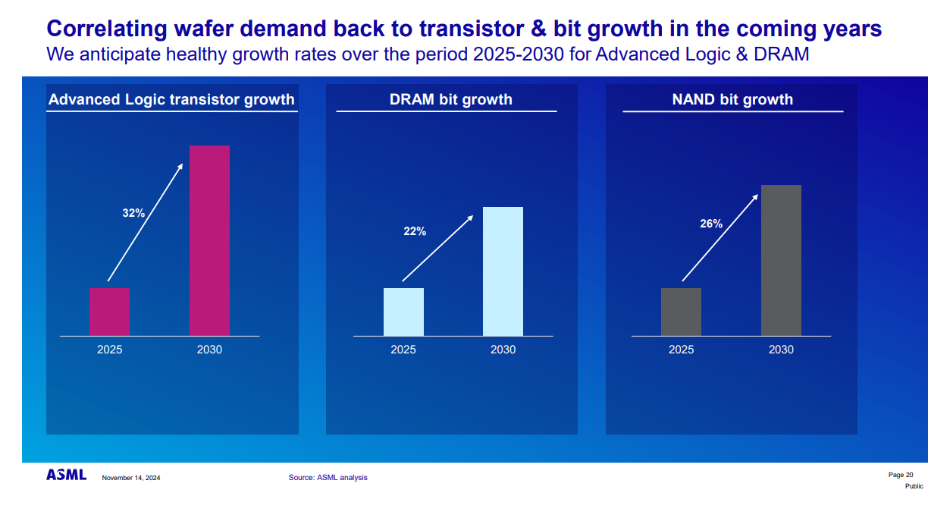
다음으로 ASML에서는 AI 시대에서의 Chip 시장 전망을  내놓았는데, AI서버에서는 원시콘텐츠의 성장, 즉 트랜지스터 성장 (=bit growth)을 보면, 추론의 경우 2025-2030년 cagr 40%~50%, 학습의 경우 50~60%이 예상된다고 한다. (오른쪽 차트) 


그외 시장별 전망을 보면, AI server 시장만 상향조정 / 그외 다른 app 시장은 하향조정


7. 

DRAM, 선단공정(7nm이하) 전망은 상향조정 / 그외 NAND, 성숙공정은 하향조정을 전망한다고 한다. 


DRAM을 한정해서 보면, 범용DRAM(D4 이하)은 앞으로 크게 성장하지 않을 것이라고 하며, 앞으로의 진정한 성장동력은 D5, HBM AI 관련된 DRAM 시장일 것이라고 한다. 이와 관련해서 구체적인 수치까지 제시해줬다.


'서버의 AI 기반 수요만 연간 월 1,000,000개의 웨이퍼가 시작될 것으로 예상되는 수준까지 올라갈 것으로 예상됩니다. 이전 슬라이드에서 총 수요가 약 2.5라고 말씀드린 것을 기억하실 텐데요, 전체 수요의 40%라고 보시면 됩니다'
 

8.

그 외에도 향 후 계측, 본딩 관련해서도 중요한 말들이 많았지만, 너무 지엽적인 기술적인 설명은 생략하고, 마지막 자본배분과 관련된 동사에 접근방법에 대해 말해보고, 최근 SEC의 자사주매입 주주환원에 대해 언급해보고자 한다.. 


' 가장 먼저 중요한 것은 우리가 창출한 현금으로 중요한 비즈니스에 대한 모든 투자를 하는 것입니다. 즉, 장기적인 로드맵을 실행하기 위한 투자입니다. 따라서 이것은 설비 투자, 이것은 R&D, 그리고 이와 관련하여 ZEISS에 대한 투자 및 대출을 지원하는 것입니다. 그래서 그게 중요합니다. 그런 다음 남은 것은 분명히 주주에 대한 환원, 지난 몇 년 동안 우리가 실행한 것처럼 시간이 지남에 따라 증가하는 지속 가능한 주당 배당금, 분기별로 지급되고 남은 것은 초과 현금으로 자사주 매입을 통해 다시 분배되고 있습니다'


10조원을 다른 근원경쟁력을 높이는데 사용했으면 어땠을까 하는 아쉬움이 남으며, 기본적으로 자사주 매입 후 소각은 단기적으로 주가를 올릴 수 있겠으나,

기술경쟁력이 뒤쳐진 상황에서는 재무악화 속도를 가속화하는 악순환의 역효과로 이어지지 않을까 우려스럽기도 하다. 

4Q24E / 1Q25E 실적에서 Nvidia향 퀄 테스트를 통과 못한다면, HBM 관련되서 그간 쌓아둔 재고 평가손을 잡아야 하지 않을까 하며, 그 액수도 상당하지 않을까 우려가 된다. 

Nvidia향 퀄 테스트가 통과된다 손 치더라도, 수율이 제대로 잡히지 않아 input cost가 타사대비 더 높을 것으로 사료되며, 후발업체로 8단 단가도 더 낮을테니, 이는 마진율 하락으로 직결되지 않을까 하며, 

SEC 1a HBM 성능열위로 일부 H100, 200 하위라인에 들어가는 HBM일 가능성이 높으니 물량도 많지 않을 것으로 사료된다. 

HBM 매출비중만 공개하는 것이 아닌 이익률까지 공개해야 어느정도 신뢰가 가지 않을까 한다.  

ASML에서도 어느정도 기류의 흐름을 잡았는지, 긴 발표시간동안 SEC에 대한 언급은 단 한 번밖에 없었으며, SKH CTO 초청인사를 전면에 내새우는 모습이다..

SEC가 계속 SF 3nm 이하, D5, HBM AI Chip 시장으로 나아가지 못한다면, 여타 다른 커머디티 산업처럼 SEC도 결국 중국과 원가경쟁을 하다 서서히 망해가는 그저그런 회사로 전락해버릴 뿐이지 않나 싶다. 


=끝

2024년 3월 12일 화요일

ARM, The everything blueprint.


격변의 과거 마이크로칩 시장에 대해 생생하게 설명해준 책이다. 

과거 마이크로칩의 탄생에서부터 1990년 노키아 휴대전화 발명, 2000년대 애플의 아이폰, 2010년 클라우드 컴퓨터, 2020년대 AI 급부상에 따른 마이크로칩의 정치적 이슈까지 기술 산업이 진화함에 따라 기업마다 갈리는 흥망성쇠, 그 원인분석까지 상세히 묘사된 책이라고 생각된다.

이 책의 저자는 이러한 모든 마이크로칩 관련 산업 변화를 'ARM' 이라는 RISC (Reduce Instruction Set Computer) 기반 '저전력' 프로세서를 설계 후 판매해 로열티/라이센스로 매출을 일으키는 회사를 중심으로 스토리를 전개해나간다.

'저전력'이라는 이점으로 글로벌 디바이스 마이크로프로세서 시장점유율 90%이상을 석권함과 동시에 이후 AI 시대가 도래함에 따라 전력난 문제가 재점화되어 ARM의 '저전력' 프로세서가 다시금 서버/IoT/pc/차량용반도체 시장에서 재조명받고 있다고 한다.

특히, AI 수요가 기존 클라우드 중심에서 '엣지 서버'로 급격히 이동함에 따라, 에너지를 덜 소비하는 데다 맞춤형 개발이 용이해 소규모 데이터센터(=엣지 서버)에 ARM의 RISC기반 '저전력'프로세서는 이상적인 솔루션이라고 한다.

그리하여 x86(CISC 기반) 프로세서로 기존 전통 컴퓨팅시장 (PC/서버)에 강자였던 Intel은 ARM의  RISC 기반 '저전력' 프로세서에 위협을 받으며, 시장점유율을 잠식당하고 있다고 한다.  

관련해, 초기 Apple의 칩 수주 경쟁에서 Intel은 기회가 분명 많이 주어졌음에도 불구하고, ARM에게 밀리는 뼈아픈 실책을 했었다고 한다. 

잡스 회고록에서는 Intel에게 당시 많은 기회를 주었지만, 그들은 좀처럼 들으려고하지 않았다고 하며, 변화에 대응하는 유연성도 많이 부족했었다고 한다.

결국 아이폰에 Intel의 프로세서는 채택되지 못한채, Intel은 기존 서버/pc시장에 안주하게 되며, 그들의 사업모델은 점차 낡아졌으며, 

반대로, 아이폰에서 시작해 apple의 거의 전 제품에 ARM의 RISC 기반으로 설계된 프로세서가 채택되며, ARM의 사업모델은 21세기형으로 불리게 됐다고 한다.

과거 Intel의 실책에 관해 당시 CEO 오텔리니는 마지막 근무일 자책하는 내용의 인터뷰를 했다고 한다. 

"우리는 관련 데이터를 활용해 말하기를 좋아하는데, 내 경력에서 아주 여러 차례 나는 직감으로 결정을 내렸어요. (아이폰 건을 놓고도) 직감을 따라야 했어요. 내 직감은 '예스'라고 말하라고 했거든요."

책을 읽고 난 뒤 지금의 삼성반도체가 SK하이닉스/마이크론 반도체에 뒤쳐지고 있는 현 상황이 과거의 Intel이 경쟁사들에게 뒤쳐져갔던 상황과 많이 겹쳐져 보였다.

이전 1990년 Intel(=삼성반도체)도 RISC 기반 마이크로프로세서 i860(=HBM)을 개발했으나, '지금까지 확실한 성과를 보인 좋은 제품을 포기하고(=GDDR) , 별 우위를 보유하지 않은 RISC 아키텍처에서(=HBM) 기존 업체들(=SKH)과 경쟁해야 할 마땅한 이유를 찾지 못해 사업을 접은 경험(=HBM)이 있다고 했다.

AI시대가 도래하지 않고 당장의 수익이 안된다는 판단에 HBM 시장을 놓쳤던 삼성
당장의 수익이 나는 D4에 안주해 D5 전환이 지연됐던 삼성
경쟁사 대비 선단공정 전환투자도 늦었던 삼성
반도체 혹한기 관리/지원부서를 앞세워 투자를 줄이며 비용통제에 나섰던 삼성
미래전략팀과 같은 컨트롤 타워가 부재한 삼성

어디서부터 삼성반도체는 첫 단추를 잘못 꿰버린걸까.. 

AI 컴퓨팅 시대가 성큼성큼 다가올수록, 경쟁사들은 재빠르게 고객사 요구에 대응하며 전사 역량을 쏟아붓는 반면, 삼성 반도체는 궤를 같이하지 못하며, 계속해서 한발 두발씩 뒤쳐지는 상황이다.

이 격차가 과연 좁혀지기나 할까..?
지금까지는 시간이 흐를 수록 격차는 점차 벌어져가고만 있다.

=끝

2020년 9월 1일 화요일

Nvidia 분석 - 1


*기업개요

 - 동사는 GPU(Graphics processing Unit) 전문 fabless 기업으로, PC/콘솔게임, data center 시장이 주 전방산업

 - 동사는 지난 5년간 PC 게임 수요가 주를 이루는 외장 GPU 시장에서 약 70%의 M/S를 유지해왔지만, 자율주행, 인공지능 분야에서 GPU 가치가 재조명 받기 시작해 동사의 새로운 성장동력이 되어 주고 있음.

*사업모델

1. Gaming

1-1)  게임사업(데스크탑 pc 게임)

 - 현재 데스크탑 게이밍용 GPU 매출의 2/3은 최근 출시한 RTX GPU에서 발생하고 있음

 - RTX 기술의 핵심은 실시간 '레이 트레이싱' 기술로 현실과 같은 광원효과를 나타내기 위해 만들어진 기법


 - 방대한 계산량 때문에 렌더링 시간이 오래 걸려 영화에 적합했었던 기술이지만, 최근 지포스 RTX는 전용 프로세서 'RT 코어'(기술발전)을 통해 게임에서도 실시간 트레이싱을 구현

 - 콜오브 듀티에 이어, 마인크래프트, 배틀필드, watch dogs 등 major game으로의 레이 트레이싱 기술이 점차 적용되고 있음


1-2) tv용 & 게임용 스트리밍  Shield RV and Shield TV Pro


 - 2019.05말 쉴드 TV 출시

 - 쉴드 TV는 TV에 연결해 다루는 스마트 콘솔로 유튜브 같은 인터넷 영상 컨텐츠나, TV용 앱, 게임을 TV에서 손쉽게 즐길 수 있게 만든 장치

 - 여타 다른 엔비디아의 쉴드 TV가 Setup box들과 다른 것은 기본 패키지에 리모컨 대신 게임패드가 있으며, 모바일 게임 app뿐 아니라 PC 게임도 쉴드 tv에서 즐길 수 있음

 - 엔비디아의 게이밍 서버에서 실행되는 PC게임은 물론 이용자의 PC에 설치된 게임까지 실시간 스트리밍 게임으로 즐길 수 있음. 

1-3) 게임 스트리밍 사업 GeForce Now

 - 1) 플레이 타임 20시간 당 $25불 부과, 2) 2019년 안으로 200개 게임서비스 오픈, 점차 무료 게임을 늘려갈 예정. 3)그 외 게임은 Steam, Uplay, 블리자드 등을 거쳐 별도 구매를 해야 함

 - 이용요금, 편의성 그리고 데이터 수 등에서 경쟁력이 부족하므로 세계 각지에 다수 게이터 센터를 보유한 Google, Microsoft 대비 경쟁력을 가질 수 있을지는 의문

 - 타 클라우드 게임사와의 차별점은 'Steam' 플랫폼을 활용해 PC,TV, 모바일에서 스트리밍 게임 서비스를 즐길 수 있다는 점

 - 독점 콘텐츠 부분에서도 경쟁사에 뒤떨어지지만, GeForce Now는 스팀 플랫폼으로 출시된 게임을 그대로 할 수 있는 것이 포인트

 - 하지만, 아직 1)5G 상용화와 2) 지역별 데이터센터 확장이 선행되어 있지 않아 실제 클라우드 게이밍 업체들의 서비스 출시 지역은 일부 국가에 한정

 - 또한, 클라우드 게이밍 환경에서는 요구사항이 높은 게임을 온전히 구동시키기 어려워 전통적 게임 플랫폼을 완벽히 대체하지는 못할 것이기 때문에 upside potential은 아직 제한적이지 않을까..? 

2. Data center

 - 현재 동사의 데이터센터향 매출성장 driver는 Conversational AI (인공지능컴퓨터가 대화속에서 '인간과 같이' 문맥을 파악하고 Intelligent reponses를 제공할 수 있는 기술)

 - (ex 구글의 BERT model : 인간의 언어를 더 잘 분석하고 이해하는 최첨단 딥러닝 알고리즘. 인공지능을 활용해 검색능력 확대. 자연어 처리 시 문맥을 보다 잘 이해해 검색 결과가 유용하도록 지원)

 - 데이터센터향 GPU 제품은 크게 2가지로 나눌 수 있는데 1)인공지능훈련용 'V100', 2)인공지능 추론 'T4'

2-1) 인공지능훈련 (Training) - V100

 - 입력 데이터를 통해 모델을 학습하는 과정으로 반복이 많은 계산 집중형 프로세스

 - 초기 인공지능은 이미지 인식이나 음성 인식의 정확성을 높이기 위해 딥러닝 모델의 규모가 커지고 입력 데이터 양이 많아지고 있음

 - 2018년 GPU는 인공지능 훈련 영역에 주로 적용되다고 2019년 인공지능 추론 영역으로 확장됐으며 3Q19기준 현재 추론용 GPU가 훈련용 GPU 판매가 더 많음

2-2) 인공지능 추론(Inference) - T4

 - 인공지능훈련으로 학습된 모델로 이미지/음성을 인식하는 등 특정 서비스를 수행하는 과정

*머신러닝/인공지능 (딥러닝)

 - 기존의 프로그램들은 프로그래머가 사전에 특정 상황을 판단하는(조건문) 알고리즘을 짠 후, 그 알고리즘 순서대로 시행하며 조건에 맞는지 아닌지 확인하는 방식으로 구성

 - 하지만, 경우의 수가 매우 많은 현실세계에서는 도저히 알고리즘 개발자가 모든 조건문을 다 적을 수 없는 레벨의 복잡도를 가지고 있음.

#기존 조건문


 - 반면, 머신러닝은 조건문이 없음, 프로그래머가 인공 뉴런을 만든 뒤, 자신이 데이터를 투입할 곳과 결괏값이 나올 곳을 지정해주고, 이후에는 인공뉴런에 확실한 데이터만을 넣어주고 

 - 결과값이 true, false인지만 피드백해주면 됨. 이 과정을 반복할 경우 인공 신경망 내의 여러 뉴런이 진화하며 결과값이 true로 산출될 확률을 높여주는 방식

 - 즉, 머신러닝은 특정 목적에 맞는 신경망을 사전에 훈련시킨 뒤, 결과를 얻어내야 할 때는 이미 훈련된 신경망에 구분하려는 내용을 넣음으로써 확인하는 방식

 - 다른말로는 프로그래머가 직접 장성해야 할 알고리즘의 상당 부분이 이제는 막대한 양의 데이터를 부어 넣는 것으로 대체된 것

#머신러닝 학습도


 - ex, 실제 안면 인식의 어려움 중 하나는 사람이 쳐다보는 각도, 주변에 있는 각종 군더더기(옷, 먼지, 노이즈, 채광 등) 등, 이런 것을 일일이 처리하는 코드를 짜는 것은 불가능

 - 하지만, 머신러닝은 인간수준의 정확도만 확보되면 되는 것이기 때문에 어느 정도오차를 허용하는 대가로 기존에 코드를 짜는 것이 불가능했던 부분을 보완

 - 신경망 학습 과정은 기존 프로그램들과 비교할 수 없을 정도로 메모리에 많은 부담이 가해짐.  기계 학습은 시간당 학습량을 최대한 늘려야 하는 '물량 공세' 방식이기 때문

 - 특정 자료를 통해 신경망을 학습시키기 위해서는 수없이 많은 샘플을 인공 신경망에 학습시키고 그 결과를 피드백 해줘야 함.

*AI, 인공지능, 자율주행 분야에서는 CPU가 아닌 GPU가 중요!

 - 이러한 학습이 필요로 하는 최대 속도는 HDD나 SSD 수준의 접근 속도로 해결할 수 있는 문제가 아님. 뿐만 아니라 CPU 근처에 있는 고속, 저용량 SRAM으로 해결할 수 있는 수준도 X

 - 저장해야 하는 학습 세트의 숫자도 클 뿐 아니라, 대부분 사진이나 음성 데이터 양이 방대하기 때문에 용량이 크면서도 전송 속도가 빠른 메모리가 필요 

 - 위의 요구사항을 충족해주는 것이 GPU

 - GPU는 CPU와 달리 연산능력보다는 더하고, 곱하고, 나누고, 평균내고 복사하는 수준의 단순한 연산밖에는 하지 못하지만 엄청난 정수 연산능력을 가지고 있음. 

 - CPU도 정수 연산장치를 늘리등 확장을 하고 있지만.. 인텔 스카이레이크 4코어 CPU에 비해 엔디비아의 지포스 1070 GPU는 정수 연산능력차이는 40배..

 - 아이러니하게도 현대 AI는 소수의 유능한 코어를 통해서가 아닌(CPU) 다수의 '무식한' 연산을 통해 작동하는 형태로 발전

 - 머신러닝은 인공 신경망을 프로그래머가 원하는 방향으로 진화시키는데, 여기에는 분기(조건문) 연산기능 (CPU) 보다는 단순한 숫자열의 곱과 합 등의 연산이 더욱 중요한 역할

 - '무식한' 연산에 특화되어 있는 만큼 GPU는 이러한 일을 매우 잘 처리했기 때문에, 기계학습이 세상으로 나오자 큰 인기를 끌게 되었음.

 - 엔디비아는 상당히 오래 전부터 이러한 단순한 병렬 연산이 자율주행, 슈퍼컴퓨터, AI, 물리 시뮬레이션 등 어떤 분야가 되었건 중요해지는 순간이 올 것임을 알고 있었음

 - 엔비디아는 자율주행, Data center 인공지능 분야 진출을 통해 그래픽카드 제조회사에서 컴퓨팅 생태계를 이끌어가는 플레이어가 될 준비를 해오고 있었음 

 - 기존 게임용 GPU보다 데이터센터 향 GPU가 수익성 도 더 좋다!